图片转提示词怎么用?反推工具的准确率实测
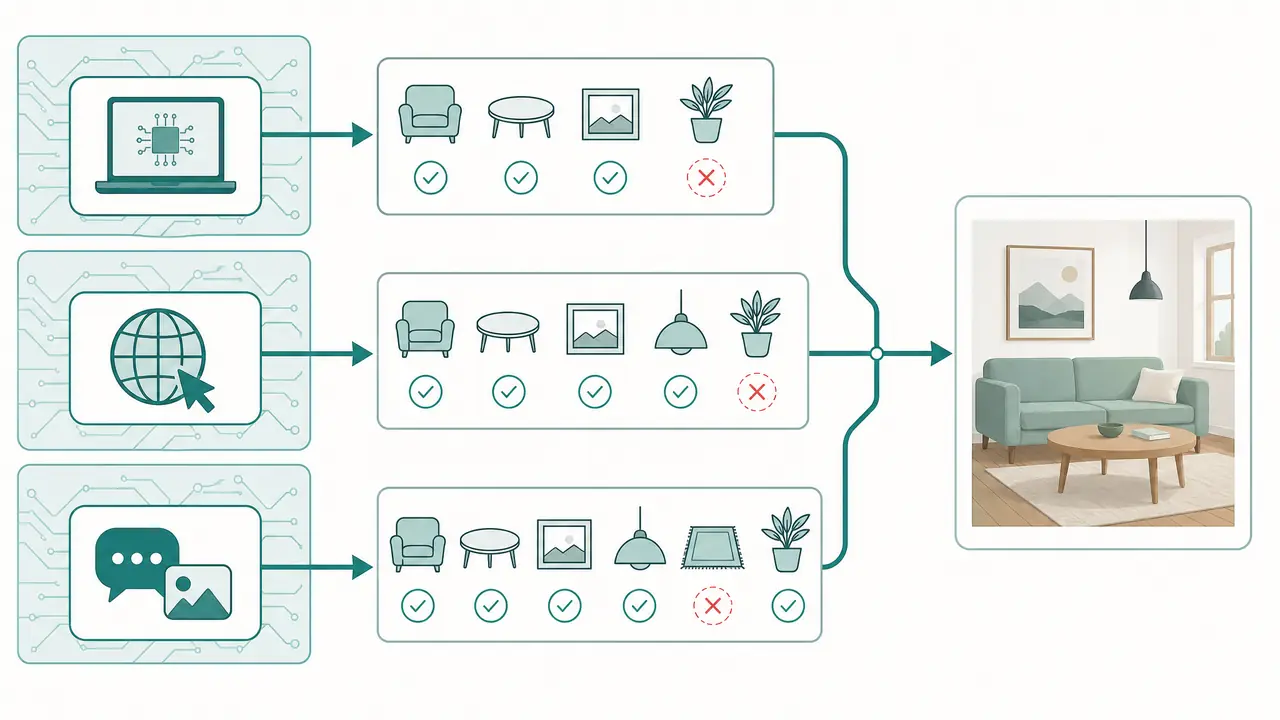
一句话版本:图片转提示词做不到一键还原原指令,实测里本地标签模型抓主体最稳、多模态对话模型补风格和构图最全、在线工具夹在中间,反推完必须手改一遍才值得用。拿一张你最常出的图,照第三节的手改流程走一遍就有数了。
把一张成图变回文字指令,也就是大家常说的图片转提示词,我以前一直当它是玄学:同一个工具,有的图反推得像模像样,有的图直接吐一串乱码标签。2026年3月,我干脆挑了五张图,把三类工具挨个喂了一遍,跑完心里就有底了。
五张图是这么选的:一张日系赛璐璐少女立绘、一张雨夜街头实拍、一张白底陶瓷杯产品图、一张留白很多的水墨山水、一张仰视机甲插画。主体、风格、构图各占一头,正好对着反推最容易丢的三样东西。工具也分三类:本地跑的标签模型(WD14 tagger 和 SD WebUI 自带的 CLIP Interrogator)、各家在线反推站、GPT-4o 这类多模态对话模型。评分就看三条——主体认没认对,风格抓没抓住,构图和镜头信息留没留下来。
测试设置先说清:一组图,三类工具,三把尺子
三类工具的底层逻辑不同:标签模型靠训练集认标签,对话模型靠视觉理解讲故事,在线工具多数只是前两者的网页封装。它们各自会丢什么,都从这里长出来。
先说本地。我常驻的是 WD14 tagger,在线版放在 SmilingWolf 的 WD14 tagger 空间,本地则用 SD WebUI 的 CLIP Interrogator 兜底。输出是标签串。二次元立绘那张,两秒出结果,"侧光""呆毛""赛璐璐"全点到了,准得吓人。可水墨山水一喂,它憋出 "no humans, greyscale, traditional media" 就收工了。真不能怪它,训练集里压根没几张国画。
本地跑最常见的坑是环境报错,装不上、显存炸、模型加载失败都算家常便饭,排查步骤可以看这篇整理:sd反推提示词报错排查。
在线工具我试了三个不同的反推站。2026年3月这批站的底层基本都是同一批开源模型换壳,同一张图传上去,出来的标签串能对上九成,区别只在有的站加了中文翻译和"一键优化"。翻译加得还行,优化就算了——有一站把 "rain, night, neon" 优化成"梦幻雨夜都市氛围感",塞回模型出图直接跑偏。老实讲,在线站真正的优势就一条:不用装环境,图一拖,五六秒出结果。省事,是真省事。没发布过的商稿别往上传,这条底线得守。
多模态对话模型用的是 GPT-4o 和 Gemini,指令就一句:"看这张图,写一条能直接用于绘图模型的英文提示词。"输出立刻不一样。雨夜街头那张,浅景深、湿地反光、霓虹色温全写进去了,是三者里唯一主动交代镜头感的。但翻车也翻在这:灯牌上一团糊掉的像素,它硬认成发光的 "OPEN" 字样,一本正经写进提示词。挺离谱的。我试了下换 Gemini 再跑一遍,它又把陶瓷杯上的一圈釉色变化,编成了"山水贴花"。这类脑补不是偶发,五张图里出现了两次。
横评结果:谁抓得住主体,谁把构图弄丢了
主体还原是本地标签模型最强,风格加构图还原是多模态对话模型最强,在线工具两头不占,只在省事这一项赢。各自最常丢的东西见下表。
| 工具类型 | 主体还原 | 风格还原 | 构图还原 | 最常丢的东西 | 我的用法 |
|---|---|---|---|---|---|
| 本地标签模型(WD14 / CLIP) | 五张对四,二次元图几乎全对 | 强,但只认训练集里的旧标签 | 基本为零 | 景别、机位、留白、情绪 | 当主体词底稿 |
| 在线反推工具 | 五张对三,产品图和水墨图翻车 | 中,翻译层还会添乱 | 基本为零 | 长尾细节标签被裁掉大半 | 换机器时应急 |
| 多模态对话模型 | 五张全认对,偶尔加戏 | 最像人话,但会脑补 | 三者中唯一能写出景别和光位 | 编造画面里不存在的细节 | 要构图骨架先用它 |
先夸本地标签模型:五张图四次把主体词放对,立绘那次连"呆毛"这个级别的小特征都没漏。但构图这一栏我只能填零——五张全试完,没有任何一组输出提到景别、机位、仰视。机甲那张明明是低角度仰拍,它就给一句 "mecha, science fiction, glowing" 完事。
对话模型正相反,构图和光位写得有模有样,代价是偶尔加戏。我个人觉得这能忍:删掉编造的部分,比凭空想构图省事多了。在线工具夹在中间,主体还原比本地少一截,白底产品图老是漏关键特征,风格词还可能被翻译层带偏。选它的理由只剩省事,外加电脑带不动本地模型这一条。
话说回来,测到一半我还干了件跑题的事:把公司楼下便利店的照片也丢进去反推,纯粹好奇。三家的输出难得达成了一致——冰柜第二层放了什么,谁都不提。机器也有不想惹麻烦的时候。
四步手改:让图片转提示词的结果真正能用
手改流程四步:删冗余标签、补构图光位、重排顺序、回测一轮,单张图的改动控制在十分钟以内。反推结果当底稿,别当成品抄。
第一步删。WD14 的输出里混着 rating 标签、质量词和一堆同义词,留着只会稀释权重;对话模型的输出则要砍形容词,"如梦似幻的氛围"这类词删掉不影响主体。第二步补,也是最关键的一步:反推丢得最狠的就是构图,景别、机位、光线方向得自己写回去,这部分机器替不了你。
第三步重排。我固定的顺序是主体、主体细节、风格、构图、光影、氛围,权重语法按你用的模型调整,SD 和 MJ 的写法差异不小,入门顺序可以看这篇:sd提示词的权重语法和负面词顺序。第四步回测:把改完的提示词丢回出图工具重画一张,跟原图对比,改一轮就收手。改两轮以上基本是自我感动,不如重画。
什么图值得反推,什么图不如自己写
最值得反推的是你自己出过又满意的图,用来沉淀风格词;别人的成图只适合学构图方向,留白类和国风图反推基本白跑。
我现在的工作流是:哪张历史出图特别满意,就顺手反推一份存进词库,下次想复用这种感觉直接调用,比凭记忆猜词靠谱。别人发在社区的优秀作品,我也会反推,但目的只有一个——看它怎么描述构图和光影,学结构,不抄词条。
几类图可以直接放弃:留白多的水墨山水,标签模型没词,对话模型只会堆"空灵意境"这种空话;带大量文字的设计图,反推出来的字全是乱码;还有就是你不想离开本机的任何图,老老实实用本地。
回到开头那张雨夜街头图。2026年3月14号晚上,三类工具喂完,最后真正能用的那条提示词,是对话模型的构图骨架、标签模型的主体词、再由我补上灯牌细节拼出来的。图片转提示词给的是七成底子,剩下三成得自己动手,短期内这个比例不会变。下次反推完,记得留十分钟手改,就当替未来的自己存一份能复用的词。
常见问题
反推出的提示词能重新生成出几乎一样的图吗?
到"同类"没问题,逐像素复刻做不到。随机种子、采样参数、模型版本这些信息本来就不在画面里,反推拿不到,接受七成相似比较现实。
本地标签模型为什么对二次元图特别准?
因为 WD14 这类模型的标签体系来自 Danbooru 图库,训练数据里二次元图的标注密度远高于实拍图和国画。喂后两类,等于让它离开舒适区,主体能认,风格和留白就顾不上了。
反推结果太长太乱,怎么快速瘦身?
按第三节四步来:先删 rating 标签和同义词,再砍文学形容词,最后按主体到氛围的顺序重排。实测一般能砍掉一半长度,出图稳定性反而更好。
上传别人的作品图做反推有风险吗?
本地模型没有上传行为,风险最低。在线工具和对话模型会把图传到对方服务器,未发布的商稿和私人照片别用这两类处理,等公开发布后再测也不迟。
延伸阅读
不想依赖工具、想练自己拆解画面的眼力,可以看这篇手动还原的做法:逆推提示词怎么做?看图反写的准确度和修补。