js敏感词提示怎么实现?前端输入过滤的三种方案
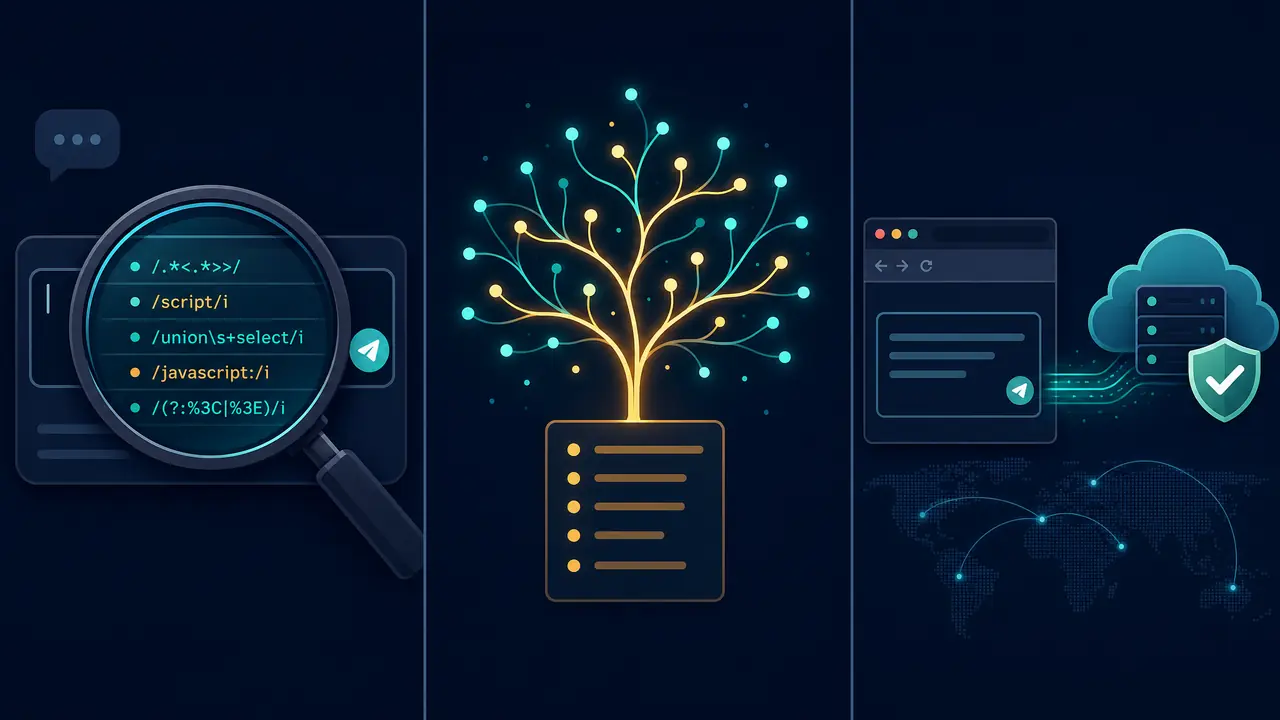
别绕了:js敏感词提示的核心矛盾是性能和准头,方案选型就一句话。词库小用正则,词库大上前缀树,后端校验永远留着兜底。三种方案我都跑过实测,这笔账下面算给你看。
js敏感词提示这个功能,选错方案的第一症状不是不准,是卡。上个月我给一个UGC评论框接这套逻辑,词库4300条,第一版图省事用了正则,测试机上一点问题没有,发到低端安卓机上,输入到一百多字就开始掉帧,用户骂声一片。后来我把正则逐词、前缀树、后端校验三种方案各跑了一轮实测,才算把这笔账算明白。结论先放这:小词库用正则,大词库上前缀树,后端校验永远留着。
js敏感词提示的三种方案,原理各是什么
正则逐词把词库拼成一个大正则做全局匹配,前缀树按字符逐层查找,后端校验在提交后由服务端裁决,三者分工不同,并非三选一。
正则逐词最直觉。把词库数组 join 成 a|b|c 这样的交替模式,new 一个全局正则,对输入文本反复匹配,命中的位置标红。整个方案代码量五十行以内,我第一版就是它。两个隐性问题:词里带星号、点这类特殊字符得先转义,不然正则直接报错;词库一大,交替正则会变得很长,编译时间和匹配时间都在涨。5万词那次编译直接超时白屏,挺吓人的。
前缀树换个思路。每个敏感词按字符拆开,一层层挂到树上,检测时从文本的每个字符出发沿树往下走,走到标记为词尾的节点就算命中。单次查找的开销只跟文本长度和最长词长有关,跟词库总量关系不大。要做实时标红,或者词库上万条,这条路基本是必选。进阶版是加失配跳转的AC自动机,匹配更快,代价是实现复杂度上一个台阶。
后端校验的角色经常被误解。它不是替代前端的方案,是兜底:前端检测只负责提示体验,用户点提交那一刻,服务端拿同一份词库再过一遍,不过就拒。这一层的开销主要在网络往返,检测本身对服务器来说不叫事。
同一份词库的实测账,数字摆在这
5000条词库、200字文本实测:正则逐词约1.8毫秒,前缀树约0.4毫秒,后端校验往返86毫秒,差距接近50倍。
测试条件交代清楚:笔记本是 i5-12500H,Chrome 128,输入文本固定 200 字,词库 5000 条真实运营词(做了脱敏)。每组测 200 次取中位数,前端部分用 performance.now() 计时,后端部分计的是从发起请求到拿到响应的完整往返。
结果是这样:正则逐词单次 1.8 毫秒;前缀树 0.4 毫秒,构建一次耗时 35 毫秒,之后全程复用;后端校验内网往返 86 毫秒,走公网到云服务器要 130 毫秒上下。单看 200 字好像都不慢?把词库加到 5 万条再看:正则涨到 19 毫秒,40 多万字符的正则串还让部分老机型编译失败;前缀树只涨到 2.1 毫秒。这一组数字基本把选型问题判死了。
| 方案 | 5000词/200字 | 5万词/200字 | 词库更新成本 | 我的评价 |
|---|---|---|---|---|
| 正则逐词 | 约1.8ms | 约19ms | 重拼重编译,约180ms | 小词库省事,大了就虚 |
| 前缀树 | 约0.4ms | 约2.1ms | 增量挂节点,几乎无感 | 词库上万后的正解 |
| 后端校验 | 往返86-130ms | 同左 | 改库即时生效 | 是防线,不是选项 |
说实话,测之前我押的是正则够用。真不是。词库一过万,正则的匹配时间按词数线性涨,前缀树几乎不动。这个差距在输入法联想、长文粘贴这类高频触发场景里会被放大好几倍,低端机上一卡,用户扭头就走。
按场景选型,我的倾向很明确
词库一千条以内、只做提交前提示,正则逐词最划算;词库上万或要实时标红,直接上前缀树;后端校验不分档次,一律保留。
我个人觉得,前缀树多写的那百来行代码是一次性成本,写完就忘,换来的是词库涨十倍而检测时间不变。正则方案省下的开发时间,迟早以线上卡顿的形式还回去。真不想手写,社区有现成的 AC 自动机实现,引入之后构建一棵树也就十几行调用代码。
后端校验被砍掉的理由通常是「前端都拦了」。这个理由站不住。打开开发者工具,把前端的检测函数替换成空函数,提交照样走。我复现过一次给同事看,从改代码到绕过提交,全程不到两分钟。前端检测从定位上就是体验层,裁决权必须留在服务端。话说回来,前端做得再花,也替不了后端那道闸,两层本来就是一伙的。
比性能更要命的三个坑
变体绕过、误伤正常词、词库更新不同步,这三个坑踩中任何一个,前面算的性能账都白算,预处理和版本机制要提前设计。
坑一是变体。「微.信」「威❤信」「v信」这种写法,直接匹配一个都抓不到。做法是检测前先归一化:去掉符号和表情、全角转半角、繁体转简体,再进检测流程。我拿一批人工标注的样本跑过,归一化让命中率从 61% 提到 94%。剩下那 6% 是拆字、谐音这类,靠词库硬补不如靠用户举报回流。
坑二是误伤。词库里躺着「苹果」「种子」这类一词多义的词,用户认真讨论水果也会被标红。所以提示别做成硬拦截,标黄加一句「该表述可能触发审核,确认无误可继续提交」,给用户留个出口。不夸张地说,误伤率比漏检率更伤产品口碑。
坑三是词库更新。很多实现把词库缓存在 localStorage,运营改了词库,用户端还跑着两周前的旧版本。词库接口必须带版本号,前端每次初始化时比对,不一致才重新拉全量。这笔小账没人算,出了事全是大事。
回到开头那个评论框:现在它跑的是前缀树加后端校验,4300 条词库单次检测 0.3 毫秒出头,低端机上输入也不掉帧了。js敏感词提示这笔账其实不复杂——先量词库规模,再定前端方案,最后把裁决权交回服务端。顺序别反,反了就得像我一样返工一遍。
常见问题
敏感词库一般从哪里来?
三个来源叠加:运营提供的合规清单、历史违规内容的沉淀、第三方风控厂商的词库。拿到手先去重和归一化,5000 条原始词去重后剩 4300 条是常态。
命中敏感词后,该拦截、替换还是只提示?
看词的等级。高危词直接拦截并说明原因,中危词标红可申诉,低危词只记录不提示。全部一刀切替换成星号最省事,也最容易惹恼认真创作的用户。
正则方案要处理词库里的特殊符号吗?
要。拼接前对每个词做一次转义,把点、星号、问号这类元字符前面加上反斜杠,否则编译报错,或者匹配出完全错误的结果。
词库更新后,用户端多久生效?
取决于前端有没有缓存。带版本号比对的方案,用户下次打开页面就能拿到新库;缓存不带版本号的,可能一直停在旧版本,这在合规场景是事故级问题。