可灵对口型提示词怎么写?唇形同步的指令细节
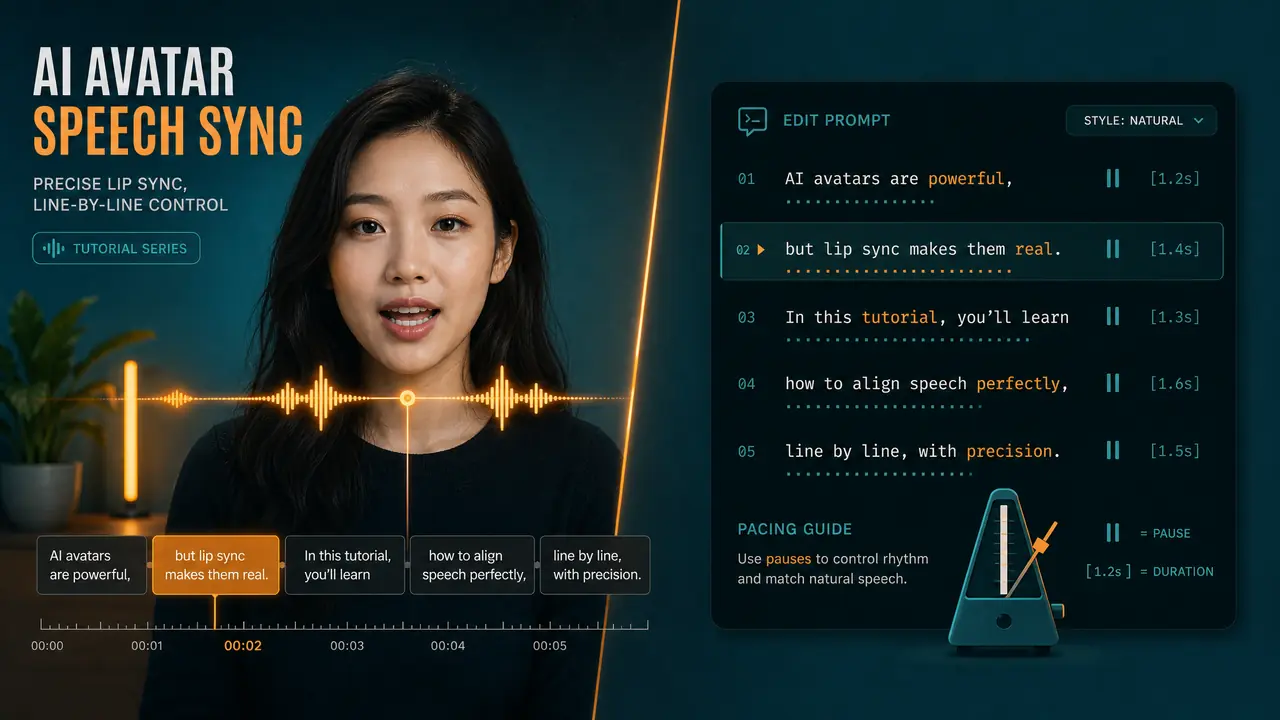
唇形翻车,十有八九不是模型不行,是口播稿没给咬字留余地。语速压到每分钟200字上下、停顿用标点提前钉死、跑对口型之前先撤掉背景音乐——这三件事做对,一次成片的概率会高很多。这篇全部是实测换来的记录。
可灵对口型提示词怎么写?先把结论放在最前面:决定唇形准不准的,不是你堆了多少风格形容词,而是要念的那段口播文本本身。语速、停顿、音画关系,这三件事在指令里交代清楚了,提示词就算到位。这个结论花了我三次翻车才敢写下来,过程一并给你。
可灵对口型提示词怎么写:指令里必须交代的三样东西
骨架只有三样:要念的口播文本、说话人的语气提示、音画关系的约束。少一样,模型就得自己猜,猜错就糊。
先把功能边界说清。可灵的对口型,公开版本走的是「文本或音频驱动人物开口」这条路:你给一段要念的话,或者上传一条录好的音频,模型让画面里的人把嘴对上。入口位置、参数名称、时长上限,各版本一直在调,以官方当前说明为准。我下面讲的,是这套流程里不怎么变的部分——指令怎么组织。
我的写法固定三行。第一行,口播文本原样放进去,一个字都不改。第二行,语气提示,一句话就够:「语速平缓,正常播报的语气,念完一句停半拍再念下一句。」第三行,音画约束:「人物只做说话时的口部动作,头部轻微自然晃动,嘴部节奏与语音逐字对齐。」三行加起来不超过八十个字,比一大段华丽描述管用。
说实话,我一开始也走过弯路,给文案前垫了两百字的画面描写,光影、景别、情绪写了一堆。结果唇形该糊还是糊。模型对口型时真正消费的是语音和文本的对应关系,你描写得再美,它也拿去管画面了,管不到嘴上。
三次翻车实录:语速才是唇形的第一杀手
口播语速一超过每分钟260字,模型咬字就跟不上;压到200到220之间,唇形同步的成功率肉眼可见地往上走。
8月26日晚上十点多,我在给一条30秒的咖啡机口播做对口型。第一版偷懒,把写好的文案整段丢进去——34秒的稿子,129个字,折下来每分钟220多字,还不算稿子里那个40多字的长句。生成出来,嘴动得很欢,字全对不上,「三秒出杯」念成了一团含糊的气音。翻车了。
第二版我学乖了点,在语气提示里加了「语速平缓」。有改善,但只救住了前10秒。长句一出来,模型开始自行压缩没念完的音节,后半段嘴和字错开半拍,看着像配音没配准的译制片。
第三版我不动提示词了,回头改稿子。每句砍到14字以内,长句拆成两个短句,句间留逗号,数字改成好念的写法。重生成,一次过。
| 版本 | 我改了什么 | 语速折算 | 对口型结果 | 我的评价 |
|---|---|---|---|---|
| v1 | 整段文案直接丢进去 | 每分钟约230字 | 前半段勉强,后半段嘴和字错开半拍 | 不及格 |
| v2 | 只加「语速平缓」的语气词 | 没变 | 前10秒准,之后开始糊 | 及格线上挣扎 |
| v3 | 重写稿子:每句不超14字,句间留逗号 | 每分钟约200字 | 全程基本对上,仅一处吞字 | 能交付 |
对比下来我的判断很偏心:改提示词的收效,远不如改稿子。语气词有用,但只能救前几秒;稿子本身不合格的,先用AI把口播稿按句重排一遍再进对口型,我写过一篇用AI生成分镜和口播稿的实战流程,那个顺序能直接套过来用。
停顿和音画对位,要在提示词里怎么交代
停顿写进稿子本身,逗号句号就是停顿指令;音画对位则要求口部动作只跟随人声,背景音乐等对口型完成后再铺回去。
老实讲,停顿是我最后才想通的一环。我最初在指令里写「适当停顿」「自然换气」,一点用没有——「适当」这两个字模型读不懂,它读得懂的是标点。把「每句不超过14字,句与句之间用逗号隔开」写死之后,停顿立刻稳了。对,就是这么玄:稿子的排版就是指令,指令反而不用写停顿。
音画对位同理。我的观察是,带着背景音乐跑对口型,嘴容易跟着节奏抢拍,鼓点一响,念词就往前赶。所以现在我的固定流程是:先拿干净人声跑唇形,生成完,在剪辑软件里把音乐和音效铺回去。一次到位,不用赌。
顺带说个跑题的事。为什么老播音员念稿都偏慢?因为中文的咬字需要时间,快了字头字腹就挤在一起。AI对口型面对的是同一个物理问题,你让它每分钟念280字,神仙也对不齐。说回来,这正好解释了为什么降速是所有修法里最优先的那个。
最后提一句边界:对口型只用在自有素材或已授权的素材上。拿别人的照片让嘴说没说过的话,性质就变了,这条线别碰。
回到开头的结论:可灵对口型提示词怎么写,核心不在形容词,在语音本身。稿子压到每分钟200字上下,停顿交给标点,音乐留到最后,三步做完再谈生成。我那条咖啡机口播,从翻车到交付只用了一晚上,方法就这么几条,剩下的就是照着排查。
常见问题
可灵对口型可以上传自己录的音频吗?
按公开资料,文本驱动和音频驱动两条路都存在,我固定用上传音频,语气和断句可控。具体入口和格式限制以官方当前版本为准。
第一次跑对口型,口播稿多长合适?
5到10秒、两三句话。先短后长,短素材把语速和停顿试对了,再上全长,省生成次数。
为什么嘴对上了,表情却很僵?
语气提示里加情绪词,比如「轻松、带一点笑意」;素材本身要选有微表情的正面镜头,一张面无表情的照片驱动不出活的脸。
数字和英文总念糊怎么办?
我把「4K」改成「四K」、「30秒」写成「三十秒」之后好了很多。念不准的词换成好念的写法,比反复重生成省时间。
对素材人物有什么要求?
正面、光线均匀、嘴巴没被口罩或手挡住。侧脸和大角度仰头的画面,唇形误差会明显变大,先裁切再生成会好一些。