视频反推提示词怎么做?把爆款视频拆成可复用指令
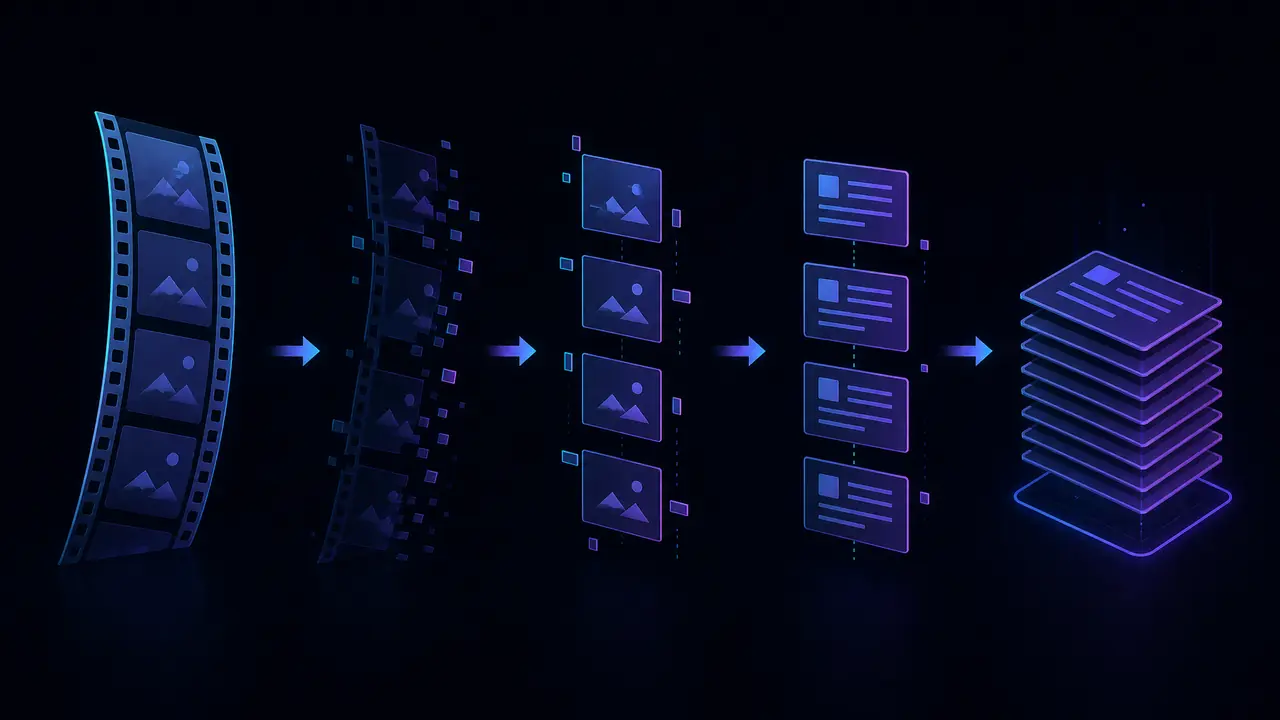
先说我的结论:视频反推提示词只能当「画面底稿」用,主体、光线、风格都能抄准,动作时序基本是丢的,想复原一条爆款,得在反推结果上手动补每 2-3 秒的动作段。这是我拿 3 条热门视频实测出来的边界。想动手的,先从最简单的一条静景视频开始拆。
视频反推提示词这条路,我在 2026 年 8 月认真走了一遍:从抖音刷到 3 条数据不错的视频,一条 12 秒的拉面师傅甩面,一条 8 秒的城市夜景航拍,一条 15 秒的口播加手势,用图生视频平台自带的反推功能挨个拆开。判断先放在这儿:反推拿到的文本,画面描述准得吓人,动作时序基本丢光,直接丢回生成器,十次有八次出一条「画面像、灵魂没了」的东西。
不甘心,所以又多折腾了两天。
下面按实测顺序写:反推给了什么,直接生成差多少,我最后留在用的拼装法。
视频反推提示词能拿到什么:3 条视频的抽帧实测
反推结果里主体、构图、光线、风格的描述都很准,动作时序几乎不给,运镜也只能拿到方向这一半。拉面那条 12 秒的视频,我按每 1.5 秒一帧抽了 8 帧,逐帧反推再合并,8 段描述里「穿白围裙的师傅在木操作台前拉伸面团」这类画面信息每帧都对得上。麻烦在这:把 8 段连起来读,你根本看不出先甩哪下、面团第几秒变细。动作顺序这一层,反推直接放弃了。
我试了下更密的抽法,0.5 秒一帧去啃卡点剪辑那条,帧是多了,描述反而开始重复,平台还会把相近动作合并成一句「人物重复相同的动作」,等于白忙。老实讲,密集抽帧只适合标动作拐点,不适合喂给反推。
夜景航拍那条就是另一个故事了。8 秒抽 5 帧,5 段描述连起来几乎是一条现成的提示词:缓慢前推、霓虹在湿路面上的反光、垂直俯拍的角度全都有。慢运镜加静景,反推能拿九成,我个人觉得这类视频甚至不用手动补。
话说回来,那两天我拆视频拆到走火入魔,午饭的麻辣烫都想抽帧拆一下,挺离谱的。这个坑别学。
直接拿反推结果重新生成,差距摆在桌面上
静景和慢运镜镜头能复原七成以上,人物大动作和手部特写必丢,5 次重生成也追不回原片的节奏。每条反推提示词我都在图生视频里跑了 5 次生成。夜景航拍 5 次里 4 次我看着能以假乱真,只是运镜速度偶尔偏慢;拉面那条 5 次全军覆没,最像的一次也只是「师傅端着面团站着」,甩面那两下彻底消失;口播那条生成的人会张嘴,手势永远对不上说话节奏,像信号不好的远程会议。
差距不是均匀分布的,我按镜头类型归了个类:
| 镜头类型 | 反推描述质量 | 复原度(我的主观分) | 一句话评价 |
|---|---|---|---|
| 静景空镜、城市航拍 | 几乎完整 | 8/10 | 直接用问题不大 |
| 慢推慢拉的运镜 | 能拿到方向 | 7/10 | 速度感偏慢,要手动提一句 |
| 人物口播 | 内容对、节奏丢 | 4/10 | 手势全靠运气 |
| 大动作(甩面、跳跃) | 只剩一个名词 | 2/10 | 必丢,别指望 |
| 手部特写 | 描述含糊 | 3/10 | 手指数量还是老大难 |
这张表里我最有感的是大动作那一行。反推给的是「师傅正在制作面条」,十二个字概括了整条视频的高潮,你要真按这个去生成,出来的就是个站着的厨师。画面层的信息反推替你干了,动作层它碰都不碰,这就是我认为反推提示词必须二次加工的原因。
反推结果加手动补动作段:我留下的拼装法
把反推文本当画面层,按 2-3 秒一段手动补动作层,每段固定写主体、动作、运镜三样,整条平均补 4-6 段。流程是我拿那 3 条视频磨出来的,分四步。
第一步抽帧。慢镜头 1.5 秒一帧,快节奏 0.5 秒一帧,这一步只为标出动作拐点,不为生成描述。
第二步取画面层。挑 3-4 个关键帧反推,删掉重复描述,留下主体、光线、风格,压到 100 字以内。
第三步补动作层,这是核心。对着原视频按时间轴写段,每段 2-3 秒,动词要具体到身体部位。拉面那条我补了 6 段,比如「0-2 秒:特写,师傅左手抓起面团两头」「2-4 秒:双臂发力向上甩,面团拉长一倍,镜头轻微上摇」。写完自己读一遍,读不出画面就重写。
第四步拆段生成再剪。15 秒的视频拆成 5-6 个 2-3 秒片段分别生成,成功率比整条生成高得多——同一条口播,整条生成我试了 5 次全废,拆段后第 2 次就出了一段能直接剪进成片的素材。真不是玄学,短片段给模型的约束更死,它没那么容易自由发挥。
补动作段这一步,和写文生视频提示词是同一套底层逻辑,主体、动作、镜头三样缺一样就跑偏,文生视频提示词的三个关键项这篇里拆得更细,可以配着看。
那天晚上我把甩面视频的 6 段动作补完重新生成,第 3 次跑出一个七成像的版本——面还是会断,但甩起来的节奏对了,我盯着看了好几遍。视频反推提示词就是一把只开画面锁的钥匙,动作那把锁得自己配。你要拆第一条的话,挑个 10 秒以内、动作简单的,别学我上来就啃 15 秒口播。
常见问题
视频反推提示词算抄袭吗?
反推产出的是对画面的文字描述,这一步不复制原视频;风险在生成结果那层,画面和原片高度相似还拿去商用,就可能踩线。我的做法是只借结构和时序,主体、场景、风格全换掉。
没有内置反推功能的工具怎么办?
截一帧丢给任意多模态模型,让它按视频提示词的格式描述画面,效果和内置反推差距不大。时序照样得手动补,这点没有捷径。
为什么反推后再生成,人物的脸会变?
反推文本通常只写到「一个女人对着镜头说话」这个粒度,五官特征在文本化那一步就丢了,属于必丢项,不是提示词写得不够多,堆形容词也没用。
这套拼装法适合 30 秒以上的长视频吗?
不建议整条拆。段数一多,前后风格容易漂,我在 20 秒这条线上停手,更长的只拆开头 10 秒定风格,后面交给自由发挥。
延伸阅读
生成端提示词的写法,可以接着看 AI 图生视频提示词怎么写;想继续打磨提示词本身,这篇 AI 提示词怎么写讲的是通用方法。